Разбор
Самообучение модели без данных
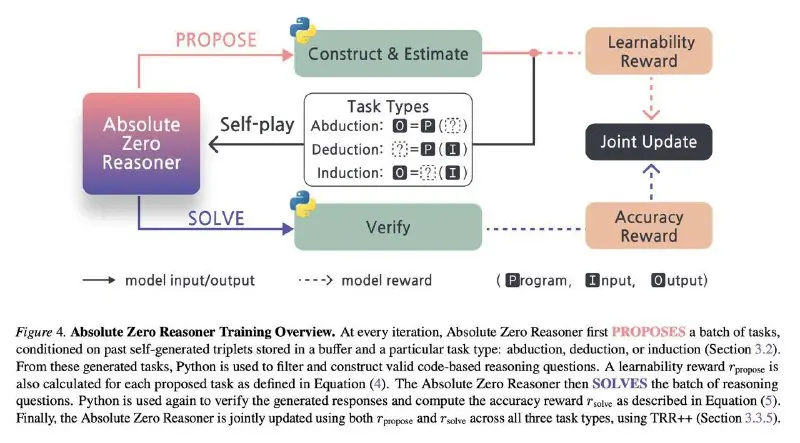
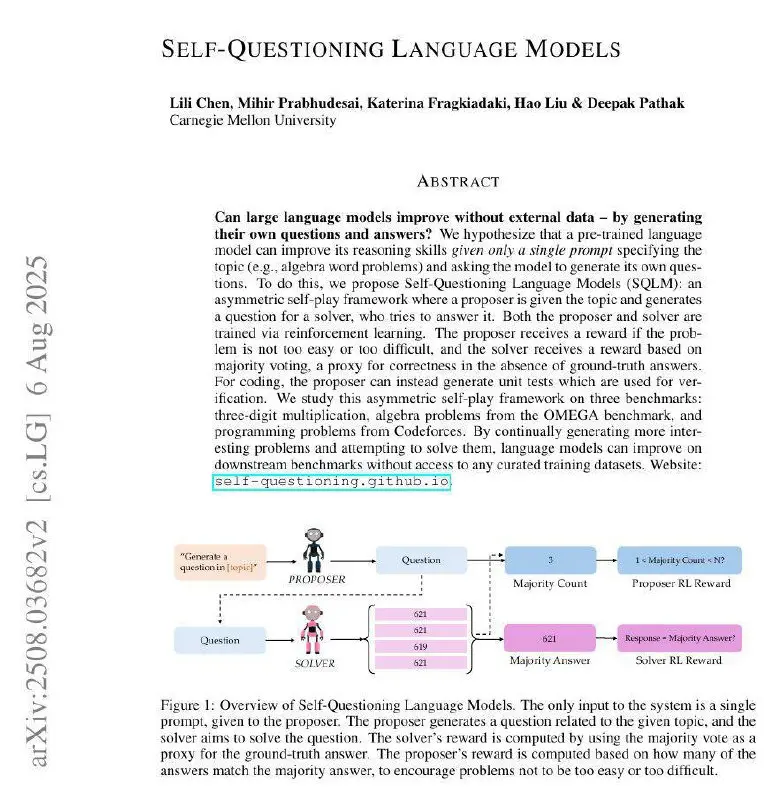
Одна из ключевых проблем - это дифицит качественных данных для обучения LLM.
- актуальные методы обучения зависят от разметки данных
- коллапс качества (деградация модели), если обучаться на синтетических данных
- reasoning-датасеты покрывают очень малую область знаний
- нужно вручную строить функции расчета награды для RL
Суть решения: Role playing из нескольких агентов. Каждый выполняет роль и в бесконечном цикле улучшается метрика.
- (Proposer): генерирует вопрос по тематике.
- (Solver): решает собственный вопрос.
- (Validator): проверяет решение — через majority voting или unit-тесты (для кода).
- (Learner): обновляет свои параметры на основе успешных примеров и ошибок.
Результат: постепенное улучшение reasoning-навыков и усложнение генерируемых задач.
Исследование:
Пример обучения: GitHub
Впервые опубликовано: @corporate_ai.