Инструмент
Mem0.ai – проект контекстной памяти для AI-агентов
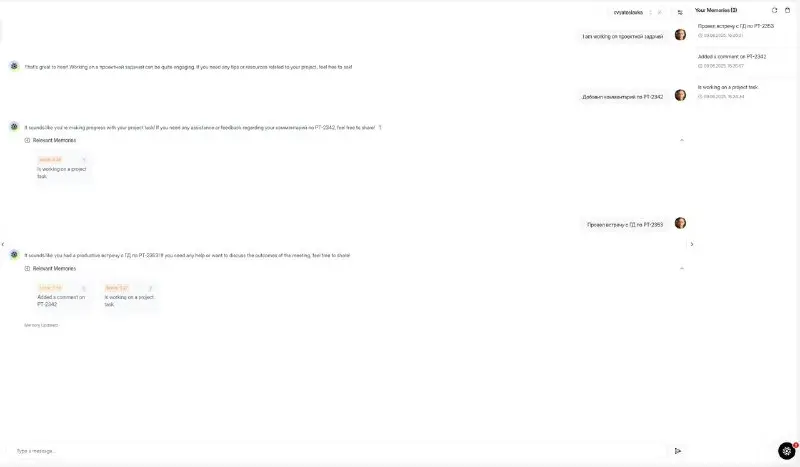
Слой памяти для персонализации AI и снижения затрат RAG-движок нового поколения: точнее, быстрее и дешевле OpenAI Memory
⚡ Когда использовать? ✅ Хотите встроить «память» и “персонализацию” в AI-ассистента ✅ Нужно сократить расходы на токены ✅ Хочется “память” без prompt-инженерии ✅ Важно ускорить отклик без потери точности
Классические решение:
- хранить сессию диалога, при перезапуске загружать в контекст prompt-a
- для каждого диалога вести временный “Context Notes” и передавать потом в Prompt
- вынести заметки в отдельную БД и при старте сессий инициировать в Prompt
- создать мини-векторную БД и там хранить контекст пользователя (mini RAG)
👨💻 Задача Сделать AI-помощника для поддержки клиентов на сайте магазина. Чтобы он был персонализированным для пользователя и учитывал его прошлый опыт взаимодействия спустя дни отсутствия.
- Без инструмента Классическая LLM-память жрёт токены
- Подгрузка всей истории в prompt
- Высокая задержка (обращение в БД, MCP-запросы)
- Высокие расходы на клиентах с большой историей
- Отсутствие точной актуализации
- Отсутствие кэширования запросов
- С инструментом Mem0: память как сервис с RAG-оптимизацией
- Подключаете Mem0 Memory (через SDK или API)
- Ассистент потребляет на 90% меньше токенов (хранит ембединги, а не весь контекст)
- Отклик быстрее на 91%, точность выше на 26%
Как это достигается (ключевые механизмы): Скорость отклика: ⚙️ 1. Контекст подаётся выборочно, а не весь ❌ В обычных LLM-пайплайнах: → Каждый запрос требует большого prompt с историей и инструкциями → LLM вынужден «думать» над всем контекстом ✅ В Mem0: → Быстрый векторный поиск сначала извлекает точный контекст → LLM получает только нужный фрагмент, а не весь диалог → Это резко снижает нагрузку и ускоряет ответ
🧠 2. Сжатая память (compressed memory) → Вместо “сырых” диалогов Mem0 создаёт краткие summary → Хранит их как embedding-представления → В retrieval используется 1 embedding = 1 “мысль”, а не 500 токенов текста → Это заменяет многословные chain-of-thought на компактные знания
🔁 3. Reuse памяти без пересылки → Память хранится на стороне Mem0, не включается в каждый запрос → LLM не «несёт» за собой всю историю — экономия на каждом инференсе → Похож на кеш: ты не платишь за то, что уже знаешь
💡 Результат: → 1 запрос ≈ 100–200 токенов вместо 1000+ → До 90% снижения затрат на inference → Особенно эффективно в долгих сессиях и B2B-ассистентах с историей общения
Полезные ссылки:
- Landing
- Docs
- [Demo] (https://app.mem0.ai/playground)
Впервые опубликовано: @ai_ossresearch.