Инструмент
Prometheus – сбор метрик SRE
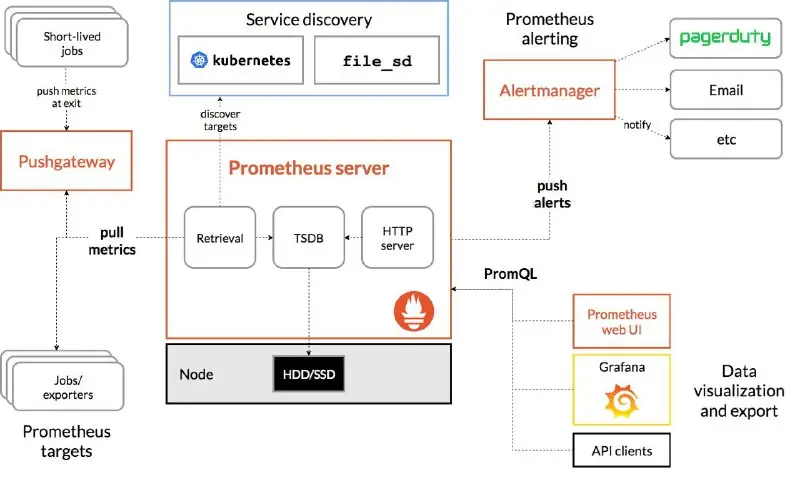
Система для сбора, хранения и анализа метрик работы серверов, приложений и сетей. Помогает следить за состоянием инфраструктуры, выявлять проблемы и отправлять уведомления в случае сбоев.
⚡ Когда использовать? ✅ Контроль метрик железа ✅ Контроль задержек API и БД ✅ Отслеживание брокеров сообщений (Kafka, RabbitMQ)
👨💻 Из практики Prometheus во многих проектов используется с Graphana для SRE. Собирает технические метрики с kubernetes, мироксервисные взаимодействия, задержку запросов, нагрузку на сервисы, очереди kafka. Дальше отдает данные в Graphana для визуализации. ИЛИ в случае сбоя идут алертинги в ТГ бот.
📝 5 шагов внедрения: 1️⃣ Определить метрики (backend, PM) – критические узлы 2️⃣ Настроить сбор данных (DevOps) – установка Prometheus и интеграция 3️⃣ Создать дашборды (DevOps) – визуализация метрик в Grafana. 4️⃣ Настроить алерты (DevOps, PM) – уведомления о проблемах в TG 5️⃣ Отладка (QA, DevOps) – эмуляция проблем и проверка реакции системы #devopstool
Впервые опубликовано: @ai_ossresearch.