ContextGem.dev –
Удобная библиотека для извлечения данных из контекста Создаёт “контекстные слои” из документов, баз данных и API, чтобы LLM могли отвечать на вопросы с точностью к фактами. PS Ранее такой же проект делали на своих инструментах - нашел классный инструмент
⚡ Когда использовать? Просто более удобная библиотека для работы с распознанием текста из больших документов. Быстрее и удобнее чем реализовывать на чистом LangChain, LlamaIndex, LlamaIndex RAG, Instructor и тп. Вся логика спрятана под капотом фреймворка
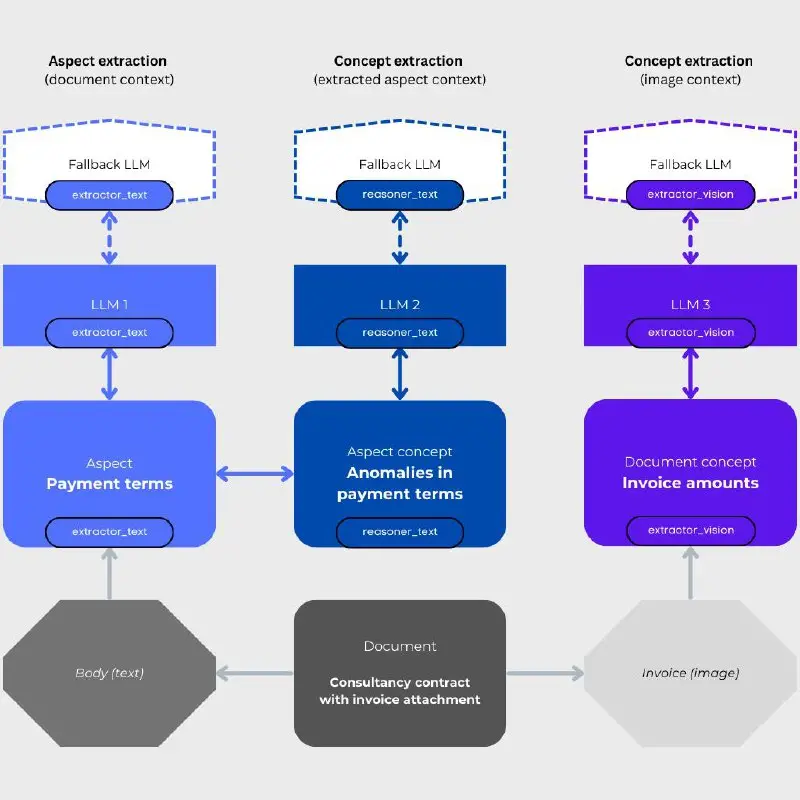
👨💻 Как работает ✅ Загрузить документ (большой объем текста для обработки) ✅ Определить Aspect (зоны которые нужно распознать) ✅ Определить Concept (мини-инструкции для распознания внутри Aspect) ✅ Настроить LLM коннектор (агент/мультиагентная схема) ✅ Запустить Pipeline обработки
На выходе за 10-15 строчек кода получаете решение 90% задач LLM модели по распознанию контекста
PS Простой и очень удобный инструмент которым сейчас активно пользуюсь в своих проектах
Впервые опубликовано: @ai_ossresearch.
Методология
Методология одной книгой
Как Product Owner ведёт запрос бизнеса от первого письма до результата, который можно показать: пять стадий, у каждой понятный выход. Оставьте почту, и я пришлю книгу.
Читать дальше
- CodeAbra/iai-personal-memory-engine
Тоже пусть тут лежит, это знакомый из Threads разрабатывает. Больше про разграничение персональных контекстов агента
- OpenObserve - открытая observability-платформа для логов, метрик, трейсов и RUM
Условный Elasticsearch/Datadog, только в разы дешевле по хранению и разворачивается одним бинарником.
- Headlong - OpenSource автономный AI-агент с постоянной рефлексией
Очень прожорливая штука по токенам, в авторах там мегакрутые чуваки (Konwinski - Perplexity & Co) - работает в фоне, а не только по запросу - сам выбирает, о чём думать и что…