Ценность информации по Хаббарду: сколько стоит знать до решения
Ценность информации — это сумма, которую разумно заплатить за знание перед решением: вероятность ошибиться, умноженная на цену ошибки. Это потолок бюджета на любое исследование — классика теории решений, которую Дуглас Хаббард перенёс в практику бизнеса: если знание не может изменить решение, его ценность — ноль, а если проверка дороже потолка, её не заказывают.
Второй вывод Хаббарда неприятен: компании тратят деньги на измерение того, что легко посчитать, и почти не измеряют то, от чего зависит результат. Он назвал это инверсией измерений. Ниже — расчёт на числах, где первые 30 ответов дают больше, чем следующие 300, и продуктовый пример с A/B-тестом. Это один из восьми методов цикла продуктовых решений при неопределённости.
Кто такой Хаббард и откуда идея
Дуглас Хаббард — американский консультант по анализу решений, основатель Hubbard Decision Research. Он известен книгой «How to Measure Anything» (2007, на русском — «Как измерить всё, что угодно»). Позже вышли «The Failure of Risk Management» и «How to Measure Anything in Cybersecurity Risk» в соавторстве с Ричардом Сейерсеном.
Свой метод он называет Applied Information Economics (AIE) — прикладная экономика информации. Суть AIE: сначала модель решения с честными диапазонами неопределённости, потом расчёт ценности информации по каждой переменной, и только потом измерения — там, где они окупаются.
Математика ценности информации появилась в теории решений 1960-х: у Ховарда Райффы и Роберта Шлайфера (1961) и у Рональда Ховарда в статье «Information Value Theory» (1966).
Заслуга Хаббарда в другом: он перенёс эту теорию на «неизмеримое» — репутацию, качество, риск, продуктивность.
Почему это важно руководителю
Метод предотвращает самую незаметную ошибку бюджета: деньги на исследование, которое не может изменить решение. Такое исследование выглядит ответственно, но покупает только задержку.
Ошибка дорога дважды. Первая цена — сам бюджет: в разборе ниже исследование за 300 тыс. ₽ проверяет решение, у которого совершенное знание стоит 93 тыс. Вторая — время: в продуктовом примере ниже месяц A/B-теста откладывает эффект в +1,2 млн ₽ в год, и эти около 100 тыс. ₽ никто не записывает в стоимость исследования.
Руководителю расчёт даёт один вопрос вместо спора о методологии: «сколько стоит ошибиться — и почему проверка дешевле?»
Измерение — это снижение неопределённости, а не точное число
Хаббард определяет измерение так: количественно выраженное снижение неопределённости на основе одного или нескольких наблюдений. Из этого следует самое важное: измерение не обязано давать точное число. Если до него вы думали «от 1% до 20%», а после — «от 4% до 9%», вы уже измерили.
Почему люди считают что-то неизмеримым, Хаббард сводит к трём заблуждениям:
- Концепция измерения. Люди думают, что измерить — значит получить точное значение. На деле — сузить диапазон.
- Объект измерения. «Лояльность» или «качество» кажутся неизмеримыми, пока их не раскрыли в наблюдаемое поведение.
- Методы измерения. Люди не знают простых приёмов: малых выборок, декомпозиции, калиброванных экспертных оценок.
Чтобы справиться со вторым пунктом, Хаббард предлагает цепочку прояснения. Если вещь важна, она наблюдаема. Если наблюдаема, её можно посчитать в каком-то количестве. Если посчитать можно, можно задать диапазон неопределённости.
Практический вопрос для любой «неизмеримой» вещи: что вы увидите по-другому, если её станет больше? Для «доверия к бренду» это может быть доля повторных покупок, время до решения о покупке, число рекомендаций.
Но одного умения измерять мало. Измерить можно всё, но не всё стоит измерять. Чтобы понять, что именно, нужна ценность информации.
Ценность информации: сколько стоит не ошибиться
Информация ценна только тогда, когда может изменить решение. Если вы поступите одинаково при любом результате исследования, его ценность равна нулю — каким бы интересным оно ни было.
Хаббард строит расчёт на одном понятии — ожидаемые потери от ошибки (Expected Opportunity Loss, EOL). Это цена ошибки, умноженная на вероятность ошибиться:
EOL = P(ошибка) × средняя цена ошибкиДальше два ключевых понятия:
- EVPI — ожидаемая ценность совершенной информации. Совершенная информация убирает неопределённость целиком, а значит и все ожидаемые потери. Поэтому EVPI равна EOL текущего лучшего решения. Это потолок: ни одно исследование не стоит больше.
- EVI (EVSI) — ожидаемая ценность несовершенной (выборочной) информации. Реальные измерения снижают неопределённость частично. Их ценность — насколько упадут ожидаемые потери после измерения.
EVI = EOL до измерения − ожидаемый EOL после измерения ≤ EVPIПравило принятия решения об измерении простое: измерять стоит, когда EVI больше стоимости измерения. А среди нескольких вариантов выбирают тот, у которого разница EVI минус стоимость максимальна.
Из формулы сразу видны две ловушки, в которые попадают чаще всего. Первая: мерить то, что и так известно с достаточной точностью, — вероятность ошибки там уже мала. Вторая: мерить то, что не меняет выбора, — цена ошибки там нулевая.
Для аналитика: формулы
Если исходов много или переменная непрерывна, EOL — среднее потерь по всем сценариям. В сценариях, где выбранное решение оказалось лучшим, потеря равна нулю:
EOL = Σ P(sᵢ) × max(0, V_лучшее(sᵢ) − V_выбранное(sᵢ))Для нормального распределения и линейной потери есть готовая функция потерь (c — цена единицы недобора, k — точка безубыточности, φ и Φ — плотность и функция стандартного нормального распределения):
EOL = c × σ × [φ(d) − d × (1 − Φ(d))], где d = (μ − k) / σРазбор на числах: запускать ли курс
В этом примере совершенная информация стоит около 93 тыс. ₽. Это всего 9% от бюджета запуска, и любое исследование дороже этой суммы — выброшенные деньги.
Условие (цифры условные, для иллюстрации):
| Параметр | Значение |
|---|---|
| Затраты на запуск | 1 000 000 ₽ |
| Цена места | 2 000 ₽ |
| Точка безубыточности | 500 продаж |
| Оценка продаж, 90% доверительный интервал | 200–1 200 продаж |
Шаг 1. Превратить диапазон в распределение. Для нормального распределения 90% интервал — это ±1,645 сигмы. Среднее = 700 продаж, σ = (1200 − 200) / 3,29 ≈ 304.
Шаг 2. Принять решение с тем, что есть. Ожидаемая прибыль (700 − 500) × 2 000 = 400 тыс. ₽, значит без дополнительных данных курс надо запускать.
Шаг 3. Вероятность ошибки. Ошибка — это запустить и продать меньше 500 мест. P(X < 500) = Φ(−0,66) ≈ 25,5%. Каждый четвёртый такой запуск убыточен.
Шаг 4. Цена ошибки. Потеря растёт линейно: каждая недопроданная до 500 единица стоит 2 000 ₽. По функции потерь из раздела «Для аналитика»: 2 000 × 304 × 0,153 ≈ 93 тыс. ₽. Монте-Карло даёт то же число. На простом языке: с вероятностью 25,5% мы потеряем в среднем около 365 тыс. ₽.
Шаг 5. Выводы.
- EVPI ≈ 93 тыс. ₽. Исследование рынка за 300 тыс. ₽ для этого решения бессмысленно, даже если оно даст абсолютную точность.
- Старт предзаписи или пилот за 10–20 тыс. ₽ — хорошая ставка: он дешевле потолка и бьёт ровно в ключевую неопределённость.
- Если бы диапазон был 600–1 200, вероятность ошибки упала бы почти до нуля — и ценность любого исследования вместе с ней. Запускайте без сомнений.
В реальной модели неизвестных несколько: конверсия, цена, стоимость привлечения, доля возвратов. Хаббард считает ценность информации по каждой переменной отдельно, и у большинства переменных она оказывается нулевой — об этом следующий раздел.
Инверсия измерений: чем важнее переменная, тем реже её меряют
Инверсия измерений — наблюдение Хаббарда: экономическая ценность измерения переменной обычно обратно пропорциональна тому, сколько внимания её измерению уже уделяют. Всё, что компания старательно считает, часто стоит измерять меньше всего.
Вывод он сделал на собственных проектах. К 1999 году Хаббард провёл анализ AIE примерно для 20 крупных IT-инвестиций, позже — ещё для 40 проектов. В каждой модели было от 40 до 80 переменных: стоимость разработки, скорость внедрения, рост продуктивности, рост выручки.
У подавляющего большинства переменных ценность информации оказалась нулевой. А переменные с высокой ценностью клиенты, как правило, никогда не измеряли. Первоисточник — книга, цитаты по открытому конспекту — в «Источниках».
Почему так получается, видно из самой формулы:
- Меряют легкодоступное. Затраты, часы, клики и лайки лежат в системах учёта. Их пересчитывают снова и снова, хотя неопределённость там и так невелика.
- Меряют привычное. Отчёт делают, потому что его делали в прошлом квартале, а не потому, что он меняет решения.
- Боятся «мягкого». Вероятность успеха проекта, скорость принятия продукта или вероятность отмены кажутся слишком размытыми — и именно там неопределённость максимальна.
Инверсия — не лень и не глупость, а системный перекос. Противоядие одно: считать EVPI по каждой переменной модели до того, как решать, что мерить. Найти кандидатов помогает карта допущений: переменные из угла «важно и нет доказательств» — первые претенденты на расчёт.
Данных нужно меньше, чем кажется
Ценность информации быстро растёт на первых десятках наблюдений, а потом почти перестаёт расти. Стоимость же растёт ровно. Поэтому самое выгодное измерение обычно маленькое.
Хаббард предлагает четыре рабочих допущения:
- Ваша задача не так уникальна, как кажется: кто-то уже измерял нечто похожее.
- У вас больше данных, чем кажется.
- Вам нужно меньше данных, чем кажется.
- Новые данные доступнее, чем кажется.
Продолжим пример с курсом. Пусть пилотная предзапись на n человек даёт оценку продаж с ошибкой 1 500/√n, а стоит 5 000 ₽ плюс 150 ₽ за ответ.
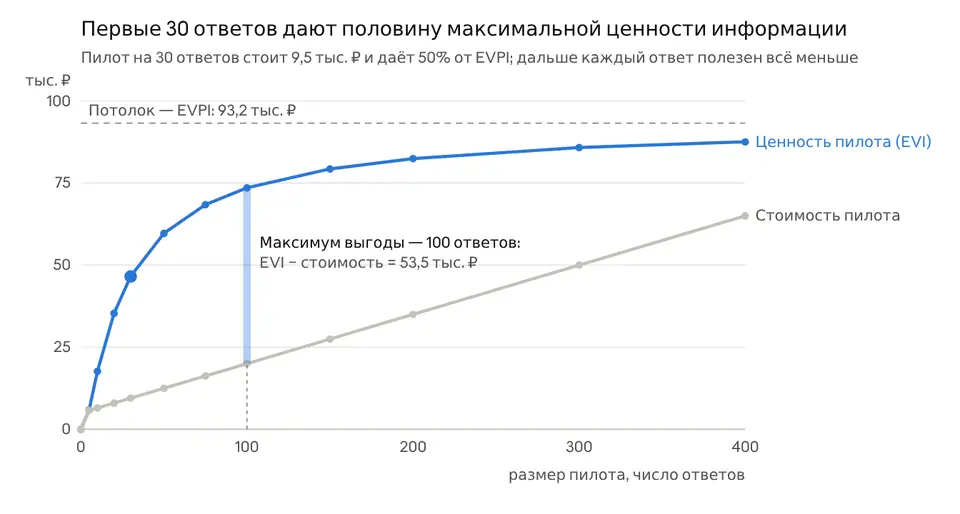
Первые 30 ответов дают половину потолка, пилот на 100 ответов — 79%. Дальше стоимость растёт быстрее ценности: на 400 ответах чистая выгода в 2,4 раза ниже, чем на 100. В нашем примере первые 30 ответов приносят около 47 тыс. ₽, а следующие 300 — ещё около 40 тыс.
Правило пяти
Возьмите случайно пять наблюдений из любой совокупности. С вероятностью 93,75% медиана всей совокупности лежит между минимумом и максимумом из них. Ошибиться можно, только если все пять окажутся по одну сторону медианы: 2 × (1/2)⁵ = 6,25%.
Урна с одним шаром
Пусть доля красных шаров в урне неизвестна и любая от 0 до 100% равновероятна. Тогда цвет одного случайного шара совпадает с цветом большинства с вероятностью 75%: если доля красных равна p, шанс совпасть с большинством — max(p, 1 − p), а среднее этой величины по всем p от 0 до 1 равно 3/4. При полной неопределённости даже одно наблюдение сильно её снижает.
Калибровка
Большинство людей самоуверенны: в их «90% интервалы» правда попадает заметно реже, чем в 90% случаев. Хаббард лечит это тренировкой: серии вопросов с обратной связью и тест равноценной ставки.
Тест такой: что вы выберете — выигрыш, если правда в вашем интервале, или рулетку с шансом 90%? Если тянет к рулетке, интервал слишком узкий. Эффект тренировки Хаббард показывает на статистике своих семинаров — это данные самого автора, а не контролируемое исследование, поэтому калибровку команды стоит проверить на тестовых вопросах. Без калибровки весь расчёт EVPI строится на песке.
Как применить: алгоритм из семи шагов
Порядок всегда один: сначала решение, потом модель, потом ценность информации и только в конце измерение.
- Сформулируйте решение. Не «понять пользователей», а «раскатывать ли новый онбординг на всех клиентов». Нет решения — нет ценности информации.
- Разложите результат на переменные. Например: число триалов × прирост конверсии в оплату × годовой чек − стоимость доработки.
- Дайте каждой переменной 90% интервал. Честный, с учётом калибровки (см. раздел выше).
- Прогоните Монте-Карло. Хватит Excel и 10 000 строк — шаблон ниже. На выходе — вероятность ошибки и распределение потерь.
- Посчитайте EVPI по каждой переменной. Для каждой переменной разбейте сценарии на 20–50 групп по её значению, в каждой группе выберите лучшее решение и посмотрите, насколько упали средние потери. Это ценность совершенной информации именно об этой переменной.
- Мерьте только лидеров, и дёшево. Одна-две переменные с наибольшей EVPI. Начинайте с минимального измерения: малая выборка, пилот, тест на части аудитории.
- Обновите модель и повторите. После каждого измерения сузьте интервал и пересчитайте EVPI. Когда она станет меньше стоимости следующего шага — перестаньте измерять и решайте.
Шаблон: модель ценности информации в Excel
Шаблон для решения «делать / не делать» с одной неизвестной и линейной потерей. Поля в угловых скобках замените своими значениями; справа — значения для примера с курсом.
Параметры
E1 = <затраты>                                   1 000 000
E2 = <цена>                                      2 000   (выручка с единицы)
E3 = <нижняя граница 90%>                        200
E4 = <верхняя граница 90%>                       1 200
E5 = E1/E2                                       точка безубыточности: 500
E6 = (E3+E4)/2                                   среднее: 700
E7 = (E4-E3)/3,29                                сигма: ≈ 304

Сценарии (строки 2–10001)
A2 = НОРМ.ОБР(СЛЧИС(); $E$6; $E$7)               продажи в сценарии
B2 = МАКС(0; ($E$5-A2)*$E$2)                     потеря от запуска; 0, если запуск окупился
Протянуть A2:B2 до строки 10001.

Итог
EVPI      = СРЗНАЧ(B2:B10001)                    ≈ 93 000
P(ошибка) = СЧЁТЕСЛИ(A2:A10001; "<"&$E$5)/10000  ≈ 25%

Если E6 < E5 (без данных вы не запускаете), потеря другая:
B2 = МАКС(0; (A2-$E$5)*$E$2)                     упущенная прибыль от отказа
Каждое нажатие F9 пересчитывает случайные числа, и EVPI немного «гуляет» — это нормально для 10 000 строк. Тот же шаблон подходит для примера ниже: вместо продаж — прирост конверсии в процентных пунктах, вместо цены — выручка за один пункт.
Пример: стоит ли месяц A/B-теста нового онбординга
Команда B2B SaaS просит месяц на A/B-тест нового онбординга. Числа условные, для иллюстрации:
| Параметр | Значение |
|---|---|
| Триалов в год | 2 400 (200 в месяц) |
| Конверсия триала в оплату сейчас | 10% |
| Годовой чек клиента | 100 000 ₽ |
| Доработка и поддержка нового онбординга за год | 1 200 000 ₽ |
| Прирост конверсии, 90% интервал | от −1 до +3 п. п. |
Что решается. Раскатывать новый онбординг на всех или нет. Один процентный пункт конверсии — это 24 клиента и 2,4 млн ₽ в год. Значит, доработка окупается с прироста 0,5 п. п.
Решение без данных. Среднее ожидание +1 п. п., σ ≈ 1,22 п. п. Ожидаемый эффект (1 − 0,5) × 2,4 млн = +1,2 млн ₽ — раскатывать.
Сколько стоит ошибка. Вероятность, что прирост окажется ниже 0,5 п. п., — около 34%. EVPI ≈ 660 тыс. ₽: это потолок для любой проверки онбординга.
Какой потолок у теста. За месяц в тест попадут 200 триалов, по 100 в группе. Стандартная ошибка разницы конверсий при 10% — около 4,2 п. п., в 3,5 раза шире исходного разброса оценки. Ожидаемая ценность такого теста — около 24 тыс. ₽, меньше 4% потолка. Трёхмесячный тест даёт около 124 тыс. ₽, или 19%.
Вывод. Месяц работы команды над тестом стоит дороже 24 тыс. ₽, а месяц задержки при ожидаемом эффекте +1,2 млн ₽ в год — ещё около 100 тыс. ₽ упущенного эффекта. На таком трафике A/B-тест конверсии в оплату почти ничего не покупает.
Разумнее раскатить онбординг с планом отката или искать переменную, по которой событий больше, чем оплат. Это вопрос к команде, а не отказ от данных.
Где метод даёт сбой
Ценность информации настолько же хороша, насколько хороша модель решения под ней. Слабые места:
- Мусор на входе. Если интервалы заданы самоуверенно, EVPI будет занижена, и важное измерение покажется лишним. Без калибровки метод теряет опору.
- Ошибка модели. Расчёт не видит переменных, которые в модель не включили. Пропущенный риск имеет EVPI, равную нулю, хотя в реальности он может быть главным.
- Тяжёлые хвосты. Нормальное распределение удобно, но продажи, вирусность контента и крупные аварии часто распределены логнормально или по степенному закону. Неверная форма распределения искажает и вероятность, и цену ошибки.
- Переменные не независимы. EVPI по одной переменной не складывается просто с другими. Корреляции (цена и конверсия, например) надо закладывать в симуляцию явно.
- Решение не всегда бинарное. В стратегии вариантов много, и часто они появляются по ходу. Иногда лучшая «информация» — это новая альтернатива, а не уточнение старых.
- Не всё сводится к деньгам. Обучение команды, доверие и подотчётность тоже ценны. Измерение с нулевой EVI для конкретного решения может быть оправдано как мониторинг или требование регулятора.
И всё же даже грубый расчёт лучше, чем никакого. Он заставляет назвать решение, выписать допущения и признать вслух, чего мы не знаем.
Чек-лист перед любым исследованием
Вопросы команде, когда она просит бюджет на исследование, отчёт, новую метрику или A/B-тест:
- Какое решение изменится от этого исследования?
- Какой результат заставит нас поступить иначе?
- Каков наш 90% интервал и откуда он?
- Какова вероятность ошибиться и сколько стоит ошибка?
- Почему проверка стоит меньше EVPI?
- Какое самое дешёвое измерение даст первую, самую ценную часть знания?
Красные флаги:
- Исследование заказано до формулировки решения. Ценность информации посчитать не из чего.
- Интервала нет, есть только «точно не знаем». Значит, никто не оценил, сколько неопределённости снимет проверка.
- Мерят то, что уже лежит в дашборде. Вероятность ошибки там обычно мала — классическая инверсия.
Если на первые два вопроса нет ответа — измерение можно не делать. Результаты дешёвых измерений стоит хранить атомарными фактами, чтобы следующее решение не начиналось с нуля.
Частые вопросы
Что такое ценность информации простыми словами?
Это сумма, которую разумно заплатить за знание перед решением. Она равна вероятности ошибиться, умноженной на цену ошибки. Если знание не может изменить решение, его ценность — ноль.
Чем EVPI отличается от EVI?
EVPI — ценность совершенной информации, которая убирает неопределённость полностью. Это потолок бюджета на любое исследование. EVI — ценность реального, неполного измерения: она всегда меньше EVPI и быстро растёт на первых десятках наблюдений.
Как посчитать ценность информации без статистического пакета?
Хватит Excel: задайте 90% интервалы для неизвестных и сгенерируйте 10 000 сценариев через СЛЧИС и НОРМ.ОБР. Посчитайте потерю в каждом сценарии (ноль там, где выбранное решение оказалось лучшим) и возьмите среднее по всем 10 000 строкам. Это и есть EVPI.
Что делать, если ценность информации мала?
Решать без дополнительного исследования. Малая ценность означает, что либо ошибка дешёвая, либо её вероятность уже низкая. Деньги на исследование в таком случае лучше потратить на другую неопределённость.
Как метод Хаббарда связан с A/B-тестами?
A/B-тест — один из способов купить информацию. Ценность информации отвечает, стоит ли его запускать и какого размера. Об ошибках при чтении самих тестов — в материале об ошибках первого и второго рода.
Источники
Числа в примерах условные: пересчитаны аналитически и моделированием Монте-Карло. Книги Хаббарда в открытом доступе нет, поэтому главы указаны по оглавлению 3-го издания на сайте Wiley, а цитаты — по открытому конспекту.
- Douglas W. Hubbard. How to Measure Anything: Finding the Value of “Intangibles” in Business. Wiley, 2007; 3-е изд. 2014. По 3-му изданию: гл. 3 «The Illusion of Intangibles», с. 29 — определение измерения и три заблуждения (концепция, объект, методы); гл. 5 «Calibrated Estimates», с. 93 — тест ставки (с. 101) и эффект тренировки (с. 111); гл. 6 — Монте-Карло, с. 123; гл. 7 «Quantifying the Value of Information», с. 145 — ожидаемые потери (с. 146) и частичное снижение неопределённости (с. 159).
- Luke Muehlhauser. How to Measure Anything, LessWrong, 2013 — конспект книги с цитатами: определение измерения, инверсия измерений, около 20 IT-инвестиций с 40–80 переменными, «правило пяти», четыре допущения.
- Douglas W. Hubbard. The Failure of Risk Management: Why It’s Broken and How to Fix It. Wiley, 2009; 2-е изд. 2020.
- Douglas W. Hubbard, Richard Seiersen. How to Measure Anything in Cybersecurity Risk. Wiley, 2016.
- Howard Raiffa, Robert Schlaifer. Applied Statistical Decision Theory. Harvard, 1961.
- Ronald A. Howard. «Information Value Theory». IEEE Transactions on Systems Science and Cybernetics, 1966, 2 (1), с. 22–26.
Методология
Методология одной книгой
Как Product Owner ведёт запрос бизнеса от первого письма до результата, который можно показать: пять стадий, у каждой понятный выход. Оставьте почту, и я пришлю книгу.
Эта статья — часть методологии: Решение: что делать в этом квартале → Решения при неопределённости
Читать дальше
- Анализ конкурирующих гипотез (ACH): как найти причину падения метрики
Анализ конкурирующих гипотез (ACH) Хойера для продукта: матрица гипотез и фактов, диагностичность, 8 шагов и что спросить у команды, когда упала метрика.
- Карта допущений (assumption mapping): что проверять до разработки
Карта допущений по Дэвиду Бланду: как за час найти убеждения, от которых зависит продукт, и оплатить их проверку раньше, чем разработку фичи.
- Атомарные исследования: как перестать платить за ресёрч дважды
Атомарные исследования (atomic research) — база фактов вместо отчётов: шаблоны факта, инсайта и решения, уровни доказательности, трассируемость и формат для RAG.