Самообучение модели без данных
Одна из ключевых проблем - это дифицит качественных данных для обучения LLM.
- актуальные методы обучения зависят от разметки данных
- коллапс качества (деградация модели), если обучаться на синтетических данных
- reasoning-датасеты покрывают очень малую область знаний
- нужно вручную строить функции расчета награды для RL
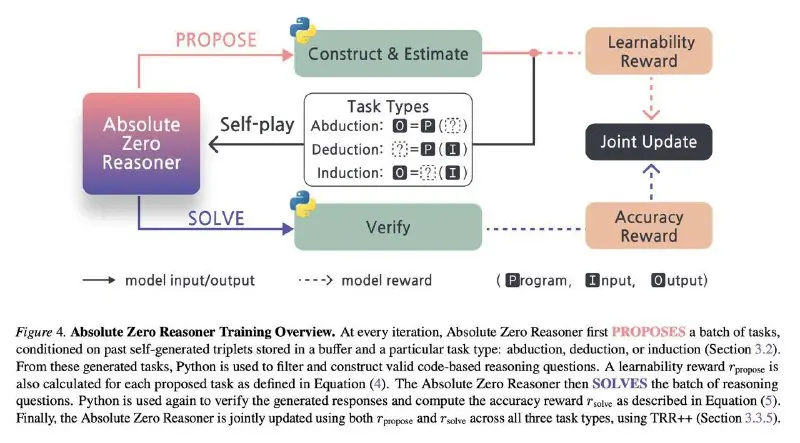
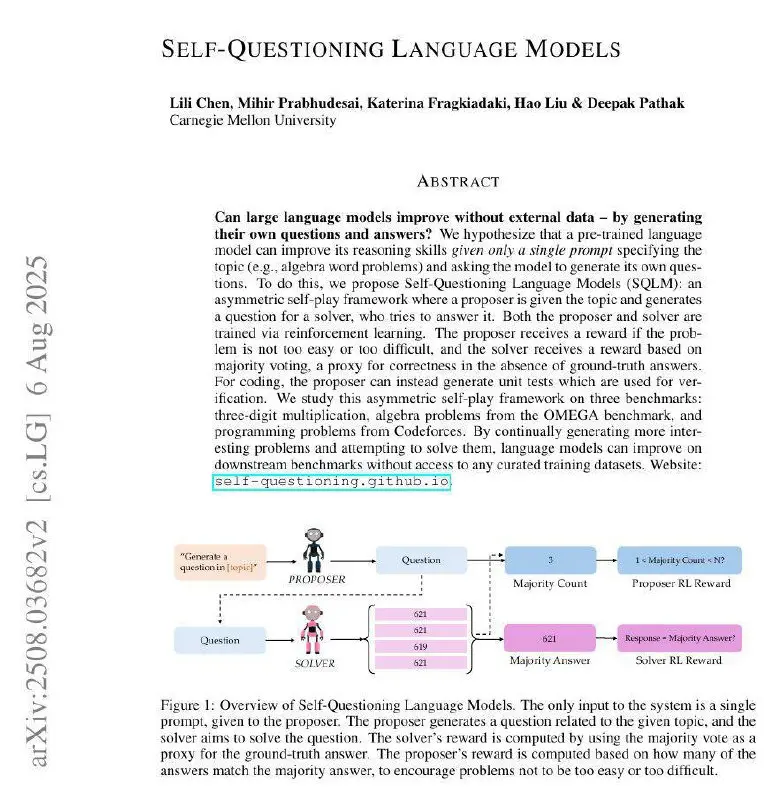
Суть решения: Role playing из нескольких агентов. Каждый выполняет роль и в бесконечном цикле улучшается метрика.
- (Proposer): генерирует вопрос по тематике.
- (Solver): решает собственный вопрос.
- (Validator): проверяет решение — через majority voting или unit-тесты (для кода).
- (Learner): обновляет свои параметры на основе успешных примеров и ошибок.
Результат: постепенное улучшение reasoning-навыков и усложнение генерируемых задач.
Исследование:
Пример обучения: GitHub
Впервые опубликовано: @corporate_ai.
Методология
Методология одной книгой
Как Product Owner ведёт запрос бизнеса от первого письма до результата, который можно показать: пять стадий, у каждой понятный выход. Оставьте почту, и я пришлю книгу.
Читать дальше
- Дизайн-дрифт в Claude Code
Ситуация Дорабатываю интерфейс от Claude Design в уже рабочем проекте Claude Code — много мелких правок на действующем коде Проблема: Через 10 итераций Claude Code сильно уходит…
- Отдельно про Backend
Для меня это отдельная боль, тк 90% всех проектов для теста гипотез - это примитивные REST сервера которые подключаются между разными сервисами.
- AI App Sec и безопасность AI-кода
Semgrep - анализирует код на уязвимости, помогает не пропустить плохие решения от AI-агента в прод и подсвечивает что и где может пойти не так. Приоретизирует ошибки и риски.