Apache Spark – фреймворк для обработки больших данных
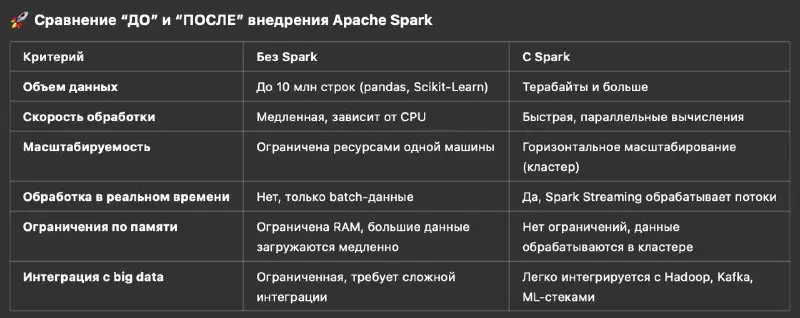
Инструмент для быстрого анализа и обработки больших объемов данных. Подходит для аналитики, машинного обучения и ETL.
⚡ Когда использовать? ✅ Анализ больших данных ✅ Обучение моделей ML ✅ Обработка логов и API-запросов
👨💻 Пример из практики: SPARK применяют при масштабировании ML моделей, чтобы уменьшить нагрузку и увеличить скорость обработки в highload ml проектах.
📝 5 шагов внедрения: 1️⃣ Настроить кластер (DevOps, Data Engineer) 2️⃣ Определить источники данных (Data Engineer) 3️⃣ Написать пайплайны обработки (Data Engineer, ML Engineer) 4️⃣ Оптимизировать вычисления (Data Engineer) 5️⃣ Тестирование и мониторинг (QA, DevOps)
🛠 Сравнение c похожими: 🔹 Hadoop → сложнее в настройке, медленнее на малых данных 🔹 Flink → лучше для потоковой обработки, но сложнее в отладке 🔹 Dask → для локальной работы с Python, не так масштабируем 🔹 Snowflake → облачный DWH, не для сложных вычислений #ops
Впервые опубликовано: @ai_ossresearch.
Методология
Методология одной книгой
Как Product Owner ведёт запрос бизнеса от первого письма до результата, который можно показать: пять стадий, у каждой понятный выход. Оставьте почту, и я пришлю книгу.
Читать дальше
- CodeAbra/iai-personal-memory-engine
Тоже пусть тут лежит, это знакомый из Threads разрабатывает. Больше про разграничение персональных контекстов агента
- OpenObserve - открытая observability-платформа для логов, метрик, трейсов и RUM
Условный Elasticsearch/Datadog, только в разы дешевле по хранению и разворачивается одним бинарником.
- Headlong - OpenSource автономный AI-агент с постоянной рефлексией
Очень прожорливая штука по токенам, в авторах там мегакрутые чуваки (Konwinski - Perplexity & Co) - работает в фоне, а не только по запросу - сам выбирает, о чём думать и что…